常见问题
平台使用与基因数据库字段的常见疑问解答,共 43 条。点击问题展开答案。
Genelibs是济南弘晖生物技术有限公司研发的一款在线服务的数据分析、挖掘软件,
该软件可以实现高通量数据的在线分析,高通数据库的本地化,数据在线挖掘等功能,
是一款较为新颖的在线分析系统。
通过在线平台中的“点击注册”功能进行自助注册。点击查看/注册
现阶段,注册用户都可以免费使用小型模块分析服务,基本可以满足简单的分析需求。
对于大型实验室和科研机构,我们准备了模块套装,可以按实验室需求定制高级模块和套装。
针对个性化的分析和研究项目需求,我们还提供定制模块服务,可以根据您的需要定制开发模块,满足分析需求。
对于大型实验室和科研机构,我们准备了模块套装,可以按实验室需求定制高级模块和套装。
针对个性化的分析和研究项目需求,我们还提供定制模块服务,可以根据您的需要定制开发模块,满足分析需求。
基因简称(gene symbol)是基因的官方缩写名称,人类基因的 symbol 由人类基因命名委员会(HGNC)统一审定,通常由若干字母和数字组成,如 TP53、BRCA1。
平台各模块均以 symbol 作为基因的主要标识。在基因详情页中还可以看到该基因的历史曾用名(previous symbols)和别名(aliases),检索时输入其中任意一个均可定位到该基因。
平台各模块均以 symbol 作为基因的主要标识。在基因详情页中还可以看到该基因的历史曾用名(previous symbols)和别名(aliases),检索时输入其中任意一个均可定位到该基因。
按照基因的产物和功能对基因进行的分类:
protein-coding gene:蛋白质编码基因;
withdrawn:已撤回的基因记录(曾被收录,后被官方撤销);
phenotype:仅有表型描述、尚未定位到具体序列的基因记录;
pseudogene:假基因(与正常基因序列相似,但已失去编码功能);
non-coding RNA:非编码 RNA 基因;
other:尚未归入以上类别的其他类型。
protein-coding gene:蛋白质编码基因;
withdrawn:已撤回的基因记录(曾被收录,后被官方撤销);
phenotype:仅有表型描述、尚未定位到具体序列的基因记录;
pseudogene:假基因(与正常基因序列相似,但已失去编码功能);
non-coding RNA:非编码 RNA 基因;
other:尚未归入以上类别的其他类型。
ensembl 是一项生物信息学研究计划,旨在开发一种能够对真核生物基因组进行自动诠释(automatic annotation)并加以维护的软件。
该计划由英国Sanger研究所Wellcome基金会及欧洲分子生物学实验室所属分部欧洲生物信息学研究所共同协作运营。
RefSeq(Reference Sequence)参考序列数据库,是美国国家生物技术信息中心(NCBI)维护的一套具有生物学意义、经过审定的非冗余基因和蛋白质序列集合,是基因组注释、序列比对和变异分析常用的基准序列来源。
locus_type 表示基因座位的类别,各取值含义如下:
gene with protein product:编码蛋白质产物的基因;
withdrawn:已撤回的基因记录;
phenotype only:仅有表型记录的基因座位;
pseudogene:假基因;
RNA, misc:其他杂类 RNA;
RNA, cluster(CRISPR RNA):成簇的、规律间隔的短回文重复序列(CRISPR)相关 RNA,与 CRISPR-Cas 系统有关,是细菌和古细菌抵御病毒等外源遗传物质入侵的防御机制;
RNA, small nuclear(snRNA):小核 RNA,是真核生物 mRNA 前体剪接体的主要成分,参与转录后加工;
RNA, small cytoplasmic(scRNA):胞质小 RNA,约 100~300 个碱基,天然状态下与蛋白质结合,参与蛋白质的合成和运输,如 SRP 颗粒即由一个 7S RNA 和蛋白质组成,负责识别信号肽并将核糖体引导至内质网;
RNA, pseudogene:假基因 RNA;
RNA, small nucleolar(snoRNA):核仁小 RNA,多由内含子编码,参与 rRNA 及其他 RNA 的加工修饰,如指导 rRNA 的核糖甲基化;
RNA, long non-coding(lncRNA):长链非编码 RNA,一类不编码蛋白质的 RNA,其基因组占比与物种复杂程度密切相关;
RNA, Y(Y RNA):Ro 核蛋白颗粒(Ro RNP)中的非编码小 RNA 成分,Ro RNP 最早是作为系统性红斑狼疮患者自身抗体的靶标被发现的;
region:区域型基因记录;
T cell receptor gene(TCR):T 细胞受体基因;
T cell receptor pseudogene:T 细胞受体假基因;
RNA, transfer(tRNA):转运 RNA,负责携带并转运氨基酸;
complex locus constituent:复合基因座组成部分;
RNA, vault:穹窿体 RNA,是穹窿体核糖核蛋白复合物中的非编码 RNA。该复合物于 1986 年被首次发现,除 RNA 外还含有穹窿体主蛋白(MVP)和少数蛋白(VPARP、TEP1),被认为与肿瘤耐药有关;
virus integration site:病毒整合位点;
endogenous retrovirus:内源性逆转录病毒;
RNA, micro(miRNA):一类由内源基因编码、长度约 22 个核苷酸的非编码单链 RNA 分子,在动植物中参与转录后基因表达调控,大多数 miRNA 基因以单拷贝、多拷贝或基因簇的形式存在于基因组中;
protocadherin:原钙黏蛋白,一类介导细胞黏附的细胞表面受体;
immunoglobulin pseudogene:免疫球蛋白假基因;
transposable element:转座因子(可移动遗传因子),指能够从基因组一个位置移动到另一位置的 DNA 序列,包括插入序列(IS)、转座子(Tn)和转座噬菌体等类型;
fragile site:脆性位点,染色体上易出现裂隙或断裂的区域;
readthrough:通读基因,因模板突变或辅助因子的帮助,RNA 聚合酶或核糖体忽略终止信号继续转录或翻译所形成的基因产物;
RNA, ribosomal(rRNA):核糖体 RNA,与蛋白质结合形成核糖体,是 mRNA 翻译的场所;
immunoglobulin gene:免疫球蛋白基因。
gene with protein product:编码蛋白质产物的基因;
withdrawn:已撤回的基因记录;
phenotype only:仅有表型记录的基因座位;
pseudogene:假基因;
RNA, misc:其他杂类 RNA;
RNA, cluster(CRISPR RNA):成簇的、规律间隔的短回文重复序列(CRISPR)相关 RNA,与 CRISPR-Cas 系统有关,是细菌和古细菌抵御病毒等外源遗传物质入侵的防御机制;
RNA, small nuclear(snRNA):小核 RNA,是真核生物 mRNA 前体剪接体的主要成分,参与转录后加工;
RNA, small cytoplasmic(scRNA):胞质小 RNA,约 100~300 个碱基,天然状态下与蛋白质结合,参与蛋白质的合成和运输,如 SRP 颗粒即由一个 7S RNA 和蛋白质组成,负责识别信号肽并将核糖体引导至内质网;
RNA, pseudogene:假基因 RNA;
RNA, small nucleolar(snoRNA):核仁小 RNA,多由内含子编码,参与 rRNA 及其他 RNA 的加工修饰,如指导 rRNA 的核糖甲基化;
RNA, long non-coding(lncRNA):长链非编码 RNA,一类不编码蛋白质的 RNA,其基因组占比与物种复杂程度密切相关;
RNA, Y(Y RNA):Ro 核蛋白颗粒(Ro RNP)中的非编码小 RNA 成分,Ro RNP 最早是作为系统性红斑狼疮患者自身抗体的靶标被发现的;
region:区域型基因记录;
T cell receptor gene(TCR):T 细胞受体基因;
T cell receptor pseudogene:T 细胞受体假基因;
RNA, transfer(tRNA):转运 RNA,负责携带并转运氨基酸;
complex locus constituent:复合基因座组成部分;
RNA, vault:穹窿体 RNA,是穹窿体核糖核蛋白复合物中的非编码 RNA。该复合物于 1986 年被首次发现,除 RNA 外还含有穹窿体主蛋白(MVP)和少数蛋白(VPARP、TEP1),被认为与肿瘤耐药有关;
virus integration site:病毒整合位点;
endogenous retrovirus:内源性逆转录病毒;
RNA, micro(miRNA):一类由内源基因编码、长度约 22 个核苷酸的非编码单链 RNA 分子,在动植物中参与转录后基因表达调控,大多数 miRNA 基因以单拷贝、多拷贝或基因簇的形式存在于基因组中;
protocadherin:原钙黏蛋白,一类介导细胞黏附的细胞表面受体;
immunoglobulin pseudogene:免疫球蛋白假基因;
transposable element:转座因子(可移动遗传因子),指能够从基因组一个位置移动到另一位置的 DNA 序列,包括插入序列(IS)、转座子(Tn)和转座噬菌体等类型;
fragile site:脆性位点,染色体上易出现裂隙或断裂的区域;
readthrough:通读基因,因模板突变或辅助因子的帮助,RNA 聚合酶或核糖体忽略终止信号继续转录或翻译所形成的基因产物;
RNA, ribosomal(rRNA):核糖体 RNA,与蛋白质结合形成核糖体,是 mRNA 翻译的场所;
immunoglobulin gene:免疫球蛋白基因。
基因位点在所在染色体中的位置。其中,代码中的p 指染色体短臂,q 指染色体长臂。q/p后面的数字代表区,点后数字代表带。例如9q21.3–q22是指:9号染色体长臂21区3带到22区.
是来源于同一个祖先,由一个基因通过基因重复而产生两个或更多的拷贝而构成的一组基因,它们在结构和功能上具有明显的相似性,编码相似的蛋白质产物, 同一家族基因可以紧密排列在一起,形成一个基因簇,
但多数时候,它们是分散在同一染色体的不同位置,或者存在于不同的染色体上的,各自具有不同的表达调控模式。
UniProt[1] 是 Universal Protein 的英文缩写,是信息最丰富、资源最广的蛋白质数据库。它由整合Swiss-Prot、 TrEMBL 和 PIR-PSD 三大数据库的数据而成。
他的数据主要来自于基因组测序项目完成后,后续获得的蛋白质序列。它包含了大量来自文献的蛋白质的生物功能的信息。
PubMed医学文献检索服务系统,其数据主要来源有:MEDLINE、OLDMEDLINE、Record in process、Record supplied by publisher等。数据类型:期刊论文、综述、以及与其它数据库链接。
Online Mendelian Inheritance in Man,在线人类孟德尔遗传数据库。持续更新的关于人类基因和遗传紊乱的数据库。
主要着眼于可遗传的或遗传性的基因疾病,包括文本信息和相关参考信息、序列纪录、图谱和相关其他数据库。
MEROPS是一个关于蛋白酶(或称为肽酶)及其抑制剂的在线网络数据库。它对蛋白酶的分类方案由Rawlings & Barrett在1993年提出,对蛋白抑制剂的由Rawlingset al.在2004年提出。
IMGT(国际免疫遗传学信息系统,ImMunoGeneTics information system)是免疫遗传学和免疫信息学领域的国际参考数据库,提供高质量的免疫球蛋白(IG,即抗体)、T 细胞受体(TR)、主要组织相容性复合体(MH)等基因的序列、命名和注释数据,覆盖人类及其他脊椎动物物种,并收录免疫球蛋白超家族(IgSF)、MH 超家族(MhSF)等相关蛋白的信息。
长链非编码 RNA(Long non-coding RNA,lncRNA)数据库。lncRNA 通过多种机制发挥生物学功能,包括基因印记、染色体重塑、细胞周期调控、剪接调控、mRNA 降解和翻译调控等。
基因表达模块展示该基因在各组织中的表达量,页面中常用术语对照如下:
Major Tissues:主要组织
Bone Marrow:骨髓;Whole Blood:全血;White Blood Cell:白细胞;Lymph Node:淋巴结;Thymus:胸腺;
Brain:大脑;Cortex:皮层;Cerebellum:小脑;Retina:视网膜;Spinal Cord:脊髓;Tibial Nerve:胫神经;
Heart:心脏;Artery:动脉;Smooth Muscle:平滑肌;Skeletal Muscle:骨骼肌;Small Intestine:小肠;
Colon:结肠;Adipocyte:脂肪细胞;Kidney:肾脏;Liver:肝脏;Lung:肺;Spleen:脾脏;Stomach:胃;
Esophagus:食道;Bladder:膀胱;Pancreas:胰腺;Thyroid:甲状腺;Salivary Gland:唾液腺;Adrenal Gland:肾上腺;
Pituitary:垂体;Breast:乳腺;Skin:皮肤;Ovary:卵巢;Uterus:子宫;Placenta:胎盘;Prostate:前列腺;Testis:睾丸;
Immune:免疫相关组织;Nervous:神经相关组织;Muscle:肌肉相关组织;Internal:内脏相关组织;Secretory:内分泌相关组织;Reproductive:生殖相关组织;
MicroArray:基因芯片(微阵列);RNAseq:转录组测序;SAGE:基因表达系列分析;
BioGPS:基因表达谱数据库;intensity:信号强度。
Major Tissues:主要组织
Bone Marrow:骨髓;Whole Blood:全血;White Blood Cell:白细胞;Lymph Node:淋巴结;Thymus:胸腺;
Brain:大脑;Cortex:皮层;Cerebellum:小脑;Retina:视网膜;Spinal Cord:脊髓;Tibial Nerve:胫神经;
Heart:心脏;Artery:动脉;Smooth Muscle:平滑肌;Skeletal Muscle:骨骼肌;Small Intestine:小肠;
Colon:结肠;Adipocyte:脂肪细胞;Kidney:肾脏;Liver:肝脏;Lung:肺;Spleen:脾脏;Stomach:胃;
Esophagus:食道;Bladder:膀胱;Pancreas:胰腺;Thyroid:甲状腺;Salivary Gland:唾液腺;Adrenal Gland:肾上腺;
Pituitary:垂体;Breast:乳腺;Skin:皮肤;Ovary:卵巢;Uterus:子宫;Placenta:胎盘;Prostate:前列腺;Testis:睾丸;
Immune:免疫相关组织;Nervous:神经相关组织;Muscle:肌肉相关组织;Internal:内脏相关组织;Secretory:内分泌相关组织;Reproductive:生殖相关组织;
MicroArray:基因芯片(微阵列);RNAseq:转录组测序;SAGE:基因表达系列分析;
BioGPS:基因表达谱数据库;intensity:信号强度。
Primer:引物
是一小段单链DNA或RNA,作为DNA复制的起始点,在核酸合成反应时,作为每个多核苷酸链进行延伸的出发点而起作用的多核苷酸链,
在引物的3′-OH上,核苷酸以二酯链形式进行合成,因此引物的3′-OH,必须是游离的。之所以需要引物是因为在DNA合成中DNA聚合酶
仅仅可以把新的核苷酸加到已有的DNA链上。
细胞分布:显示该基因及其编码蛋白质在细胞中的位置和分布情况。
例如:CCND1 是与细胞分裂相关的基因,具有保守性,其主要作用区域为细胞核(参与有丝分裂)和细胞质(参与细胞膜与细胞骨架的形成),其异常可能引起肿瘤;RIT1 是编码转运蛋白的基因,其编码的蛋白质几乎全部定位于细胞膜上。
例如:CCND1 是与细胞分裂相关的基因,具有保守性,其主要作用区域为细胞核(参与有丝分裂)和细胞质(参与细胞膜与细胞骨架的形成),其异常可能引起肿瘤;RIT1 是编码转运蛋白的基因,其编码的蛋白质几乎全部定位于细胞膜上。
gene ontology:基因本体数据库,涵盖生物学的三个方面:
细胞组分(cellular component):细胞的每个部分和细胞外环境。
分子功能(molecular function):可以描述为分子水平的活性(activity),如催化(catalytic)或结合(binding)活性。
生物过程(biological process):生物学过程系指由一个或多个分子功能有序组合而产生的系列事件。其定义有广义和狭义之分,在词义上可以区分为泛指和特指。
一般规律是,一个过程是由多个不同的步骤组成。需要指出的是,生物学过程与途径或通路(pathway)不是同一回事。
目前收录了以下 5 个相互作用数据库的内容:
STRING:蛋白质功能关联预测数据库。蛋白质之间的功能联系通常可以从编码它们的基因之间的关系推断:行使相同功能的基因在相近物种中表现出保守性,在基因组上位置相近(原核生物中),并常参与基因融合事件。STRING 将来自不同证据类型的关联整合到一个统一的评分框架中,为每对预测的相互作用给出置信度得分,并以网络图的形式展示蛋白质之间的功能联系,便于对生物过程进行模块化分析。(网址 http://string.embl.de/)
BioGRID:生物相互作用通用数据仓库。BioGRID 是开放获取的数据库,收录从原始生物医学文献中人工审编的遗传相互作用和蛋白质相互作用,覆盖酵母、拟南芥、线虫、果蝇等多种模式生物。数据可通过交互式界面免费访问和批量下载,并提供图形化查看器、REST 服务和 Cytoscape 插件等分析工具。(网址 http://thebiogrid.org)
IntAct:开源分子相互作用数据库。IntAct 提供蛋白质相互作用的存储、描述和分析工具,支持在基因本体(Gene Ontology,GO)注释背景下浏览相互作用网络,并可通过网络服务直接获取 XML 格式的相互作用数据。(网址 http://www.ebi.ac.uk/intact)
mentha:整合多来源的蛋白质相互作用数据库。其数据来自 IMEx 联盟中经人工审编的蛋白质-蛋白质相互作用数据库,汇总了多个物种的相互作用记录,并利用全部支持证据为每对相互作用计算可靠性评分,覆盖人、拟南芥、秀丽隐杆线虫、果蝇、大肠杆菌 K12、小鼠、大鼠、酿酒酵母等物种。(网址 http://mentha.uniroma2.it)
MINT:分子相互作用数据库(Molecular INTeraction database)。MINT 从同行评议期刊发表的文献中提取实验细节,以结构化格式存储分子相互作用信息,专注于经实验验证的蛋白质间物理相互作用,不包含遗传或计算推断的相互作用。MINT 还包含 HomoMINT,收录模式生物中与人类蛋白质直系同源的相互作用数据。(网址 http://mint.bio.uniroma2.it)
Reactome:生物通路知识库。Reactome 是经人工审编、同行评议的人类生物过程数据库,其基本单位是反应,反应按因果链组织为通路,涵盖代谢、信号转导、细胞周期等过程。数据库内容在开源条款下公开,可免费获取和再分发。(网址 http://www.reactome.org)
STRING:蛋白质功能关联预测数据库。蛋白质之间的功能联系通常可以从编码它们的基因之间的关系推断:行使相同功能的基因在相近物种中表现出保守性,在基因组上位置相近(原核生物中),并常参与基因融合事件。STRING 将来自不同证据类型的关联整合到一个统一的评分框架中,为每对预测的相互作用给出置信度得分,并以网络图的形式展示蛋白质之间的功能联系,便于对生物过程进行模块化分析。(网址 http://string.embl.de/)
BioGRID:生物相互作用通用数据仓库。BioGRID 是开放获取的数据库,收录从原始生物医学文献中人工审编的遗传相互作用和蛋白质相互作用,覆盖酵母、拟南芥、线虫、果蝇等多种模式生物。数据可通过交互式界面免费访问和批量下载,并提供图形化查看器、REST 服务和 Cytoscape 插件等分析工具。(网址 http://thebiogrid.org)
IntAct:开源分子相互作用数据库。IntAct 提供蛋白质相互作用的存储、描述和分析工具,支持在基因本体(Gene Ontology,GO)注释背景下浏览相互作用网络,并可通过网络服务直接获取 XML 格式的相互作用数据。(网址 http://www.ebi.ac.uk/intact)
mentha:整合多来源的蛋白质相互作用数据库。其数据来自 IMEx 联盟中经人工审编的蛋白质-蛋白质相互作用数据库,汇总了多个物种的相互作用记录,并利用全部支持证据为每对相互作用计算可靠性评分,覆盖人、拟南芥、秀丽隐杆线虫、果蝇、大肠杆菌 K12、小鼠、大鼠、酿酒酵母等物种。(网址 http://mentha.uniroma2.it)
MINT:分子相互作用数据库(Molecular INTeraction database)。MINT 从同行评议期刊发表的文献中提取实验细节,以结构化格式存储分子相互作用信息,专注于经实验验证的蛋白质间物理相互作用,不包含遗传或计算推断的相互作用。MINT 还包含 HomoMINT,收录模式生物中与人类蛋白质直系同源的相互作用数据。(网址 http://mint.bio.uniroma2.it)
Reactome:生物通路知识库。Reactome 是经人工审编、同行评议的人类生物过程数据库,其基本单位是反应,反应按因果链组织为通路,涵盖代谢、信号转导、细胞周期等过程。数据库内容在开源条款下公开,可免费获取和再分发。(网址 http://www.reactome.org)
MicroRNA (miRNA) 是一类内生的、长度约为20-24个核苷酸的小RNA,其在细胞内具有多种重要的调节作用。每个miRNA可以有多个靶基因,而几个miRNA也可以调节同一个基因。
这种复杂的调节网络既可以通过一个miRNA来调控多个基因的表达,也可以通过几个miRNA的组合来精细调控某个基因的表达。据推测,miRNA调节着人类三分之一的基因。最近的研究表明大约70 %的哺乳动物miRNA 基因是位于TUs区
( transcription micro RNA micro RNA units , TUs ) ( Rodriguez et al ,2004) , 且其中大部分是位于内含子区( Kim &Nam , 2006) 。
一些内含子miRNA 基因的位置在不同的物种中是高度保守的。miRNA 不仅在基因位置上保守, 序列上也呈现出高度的同源性(Pasquinelli etal , 2000 ; Ruvkun et al , 2001 ; Lee & Ambros ,2001) 。
miRNA 高度的保守性与其功能的重要性有着密切的关系。miRNA 与其靶基因的进化有着密切的联系, 研究其进化历史有助于进一步了解其作用机制和功能。
基因通路:人体基因组图谱好比是一张能说明构成每一个人体细胞脱氧核糖核酸(DNA)的30亿个碱基对精确排列的“地图”。科学家们认为,通过对每一个基因的测定,人们将能够找到新的方法来治疗和预防许多疾病,如癌症和心脏病等。
该图非常形象地把基因家族的各种基因描绘出来。
20世纪50年代以后,随着分子遗传学的发展,尤其是沃森和克里克提出双螺旋结构以后,人们才真正认识了基因的本质,即基因是具有遗传效应的DNA片断。
研究结果还表明,每条染色体只含有一个DNA分子,每个DNA分子上有多个基因,每个基因有含有成百上千个脱氧核苷酸。由于不同基因的脱氧核苷酸的排列顺序(碱基序列)不同,因此,不同的基因就含有不同的遗传信息。
KEGG pathway:(Kyoto Encyclopedia of Genes and Genomes)KEGG(京都基因与基因组百科全书)是基因组破译方面的数据库。在后基因时代一个重大挑战是如何使细胞和有机体在计算机上完整的表达和演绎,
让计算机利用基因信息对更高层次和更复杂细胞活动和生物体行为作出计算推测。为达到此目的,人们建立了一个在相关知识基础上的网络推测计算工具。在给出染色体中一套完整的基因的情况下,
它可以对蛋白质交互(互动)网络在各种细胞活动起的作用作出预测。 KEGG 的PATHWAY 数据库整合当前在分子互动网络(比如通道,联合体)的知识,KEGG 的GENES/SSDB/KO 数据库提供关于在基因组计划中发现的基因和蛋白质的相关知识,
KEGG 的COMPOUND/GLYCAN/REACTION数据库提供生化复合物及反应方面的知识。
Reactomepathway:反应组学(Reactome, http://www.reactome.org)是一个汇集了由专家撰写,经同行评阅的有关人体内各项反应及生物学路径的文章的数据库,该数据库相当于一个有效的数据资源以及电子图书。
该库目前发布了共计2975个人类蛋白、2907项生物学反应以及4455个引用文献。该数据库为人们提供了一个全新的从整体水平上对生物学途径进行研究的工具,同时,它也是一个改良的搜索及数据挖掘工具,可以简化与生物学途径相关的数据搜索与研究。
此外,对用户提供的高通量数据组进行分析,也变得更为简单。目前,由于直系同源预测方法的改进,反应组学数据库也开始收录其它模式生物的数据了,现在通过与其它数据库合作和人工注释方式,已经收录了包括拟南芥(Arabidopsis)、
水稻(Oryza sativa)、果蝇(Drosophila)及原鸡(Gallus gallus)等22种模式物种的反应组学数据。反应组学的数据库内容和相关软件都是开源共享,免费使用的。
基因相关疾病:因该基因异常可能引起的疾病,或该基因变异会导致发病风险升高的疾病。
数据来源之一为 BeFree(Bio-Entity Finder and Relation Extraction)数据库。BeFree 是基于文本挖掘技术的生物医学信息抽取工具:首先通过生物医学命名实体识别(BioNER)模块在文献中识别基因、疾病等实体,然后利用基于支持向量机(SVM)的关系抽取模块识别这些实体之间的关联,从而从科学出版物中提取基因与疾病的关联信息。
数据来源之一为 BeFree(Bio-Entity Finder and Relation Extraction)数据库。BeFree 是基于文本挖掘技术的生物医学信息抽取工具:首先通过生物医学命名实体识别(BioNER)模块在文献中识别基因、疾病等实体,然后利用基于支持向量机(SVM)的关系抽取模块识别这些实体之间的关联,从而从科学出版物中提取基因与疾病的关联信息。
基因相关文献模块收录与该基因相关的已发表研究论文,文献数据来源于 PubMed 等公开数据库,涵盖该基因的功能研究、疾病关联、表达调控等方向,并持续更新。点击文献标题可查看文献详情。
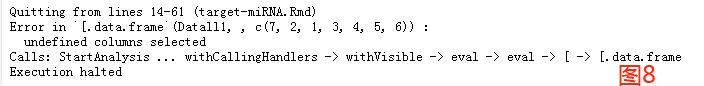
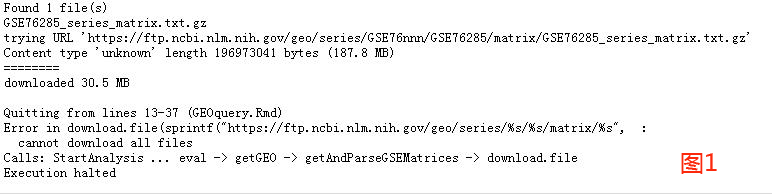 问题:网络原因,数据未下载全.
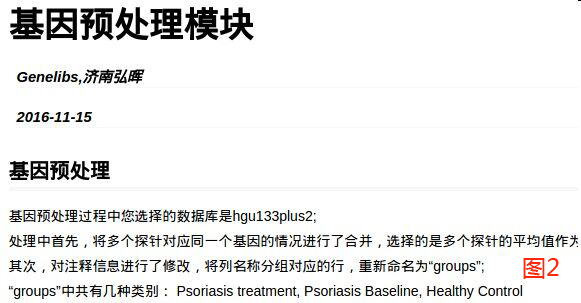
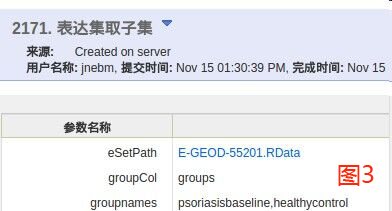 问题:分组信息中名称不一致(大小写及空格)
 处理:利用“预处理”模块进行转换
步骤:
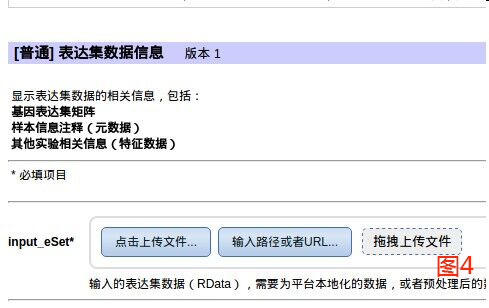
1、将RDATA放入“表达集数据信息”(图4),点击运行生成两个csv文件(图5)
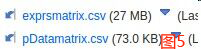
2、打开pDatamatrix.csv,找到其中的分组信息所在的列,更改列名称(groups)及组别名称信息(如去除空格等),并保存
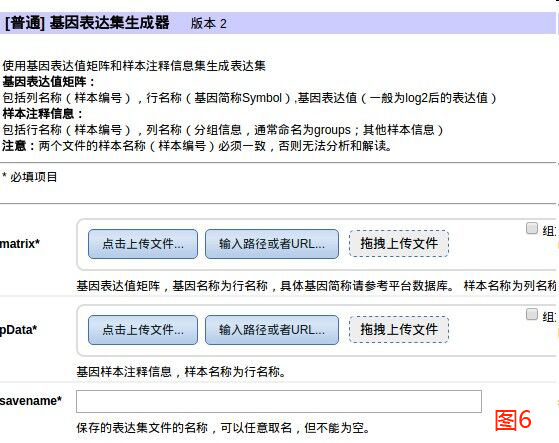
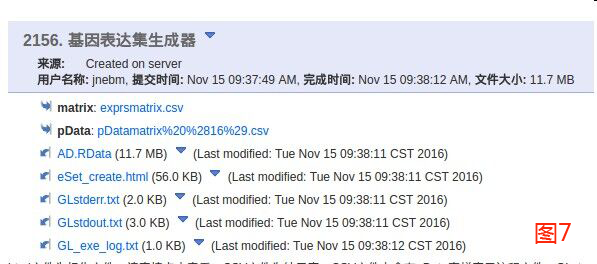
3、将修改好的pData文件上传到“基因表达集生成器”中(图6),点击运行生成新的RData(图7)
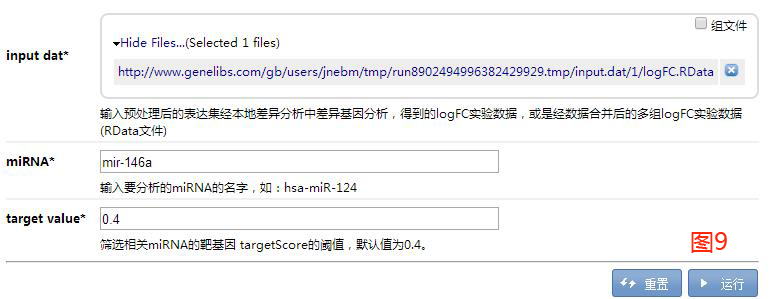
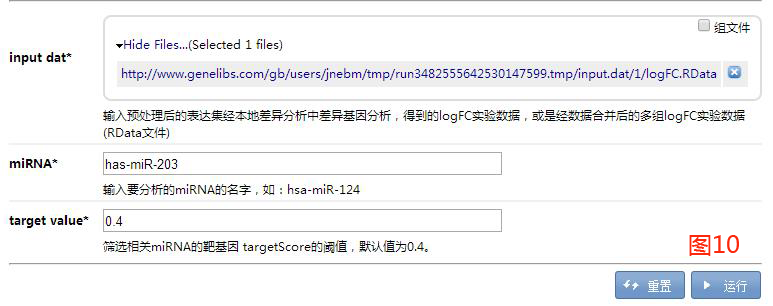 问题:miRNA名称填写错误:图9未写“hsa”;图10将“hsa”写成了“has”
处理:miRNA名称格式要与要求填写的格式一致,如:hsa-miRNA-124