文章中心
了解、体验、感悟、分享——汇聚平台使用教程与科研动态。
可解释机器学习提前预判儿童癫痫对吡仑帕奈早期疗效
原文:Explainable Machine Learning for Predicting Early Response to Perampanel in Pediatric Epilepsy: A Real-World Study.
期刊:Drug design, development and therapy(影响因子 6.1) | PubMed | PMC 全文(含 PDF)
关键图表
儿童癫痫是一种常见的慢性神经系统疾病,反复发作会持续损害患儿的认知发育、学业表现和长期生活质量。流行病学数据显示,儿童癫痫年发病率约为每10万人中50例,其中近30%的患儿即便使用了两种或以上恰当选择的抗癫痫发作药物(ASM),仍无法获得满意的发作控制,最终进展为药物难治性癫痫(DRE)。这类患者面临神经精神共病、住院率升高、死亡风险增加等多重威胁,也给家庭带来沉重的长期照护负担。因此,优化儿童DRE的药物治疗策略,一直是临床上的重点难题。
吡仑帕奈(Perampanel,PER)是一种选择性、非竞争性的AMPA受体拮抗剂,为儿童难治性癫痫提供了新的药理选择。真实世界研究已表明,PER对局灶性和全面性癫痫均具有临床意义的发作控制效果,且总体耐受性可接受。然而,患儿之间的治疗反应差异很大:部分儿童发作明显减少,另一些则获益有限,甚至因不良反应停药。既往研究多聚焦单一临床因素,例如合并ASM数量较少、基线发作频率较低者结局更好,而合用酶诱导型ASM可能降低PER血药浓度。但PER的药代动力学和临床疗效同时受年龄、体重、病程、合并用药等多因素交织影响,传统单因素或基于logistic回归的列线图难以捕捉变量间复杂的非线性关系与交互作用。临床实践中,仍缺乏能在用药前或用药早期可靠识别“谁能从PER中获益、谁可能无效”的工具。
研究背景:为什么需要早期预测工具
在儿童癫痫治疗中,启动PER后的前2个月是一个具有临床可操作性的窗口期:涵盖剂量滴定、早期耐受性评估以及发作频率变化的初步判断。若能在第8周左右就判断患儿是否属于“无应答者”,医生便可及时调整方案,避免无效暴露和潜在不良反应。然而,现有模型大多针对更长期或混合人群的结局,不能提供基于常规临床变量、面向儿童、且聚焦早期(2个月)风险分层的工具。
本研究将“早期应答”定义为:在PER启动后8周内,与用药前4周基线期相比,发作频率减少≥50%者为应答者(responder),未达到者为无应答者(non-responder)。这一8周终点仅用于定义早期反应,并不评估长期有效性、持久性或安全性。模型定位是“早期治疗风险分层工具”,而非长期无发作预测工具。
核心发现:七变量集成模型表现良好
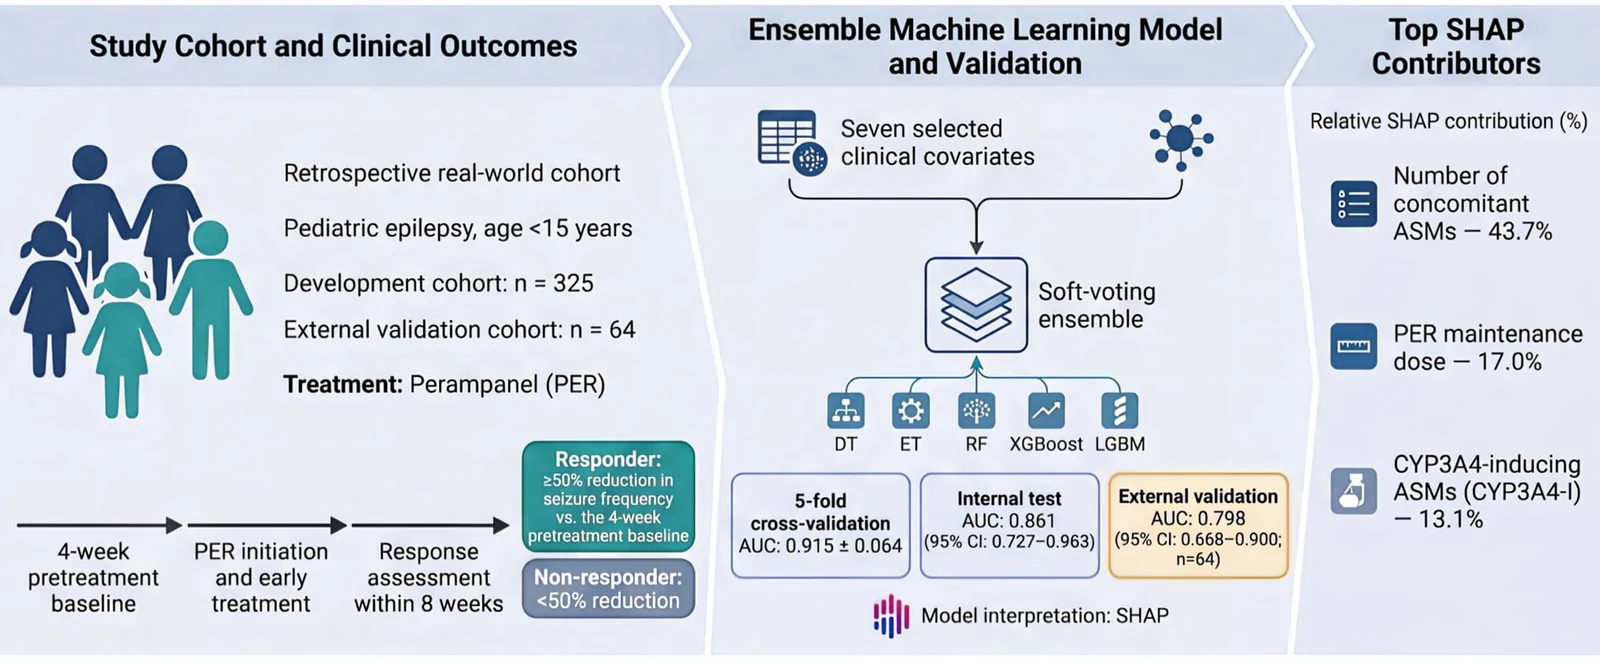
研究团队回顾性纳入了2021年1月至2025年12月期间在所在机构启动PER治疗的325例15岁以下癫痫患儿(CWE)。所有患儿均有PER用药前至少4周的完整基线发作频率数据,并完成了2个月疗效评估。排除依从性差、因不耐受或不良事件在评估前停药、以及病历不完整者后,最终数据集包含325名患者和25个特征。
通过LightGBM特征重要性排序结合前向特征选择,研究从众多临床协变量中筛选出7个核心变量:合并ASM数量、年龄、PER维持剂量、性别、CYP3A4酶诱导剂(CYP3A4-I)使用、发育迟缓和/或行为异常(DD/BA)、病程。随后,研究比较了11种机器学习算法(AdaBoost、朴素贝叶斯、人工神经网络、决策树、Extra Trees、GBM、KNN、LightGBM、随机森林、XGBoost、SVM),并基于软投票(soft voting)策略构建集成模型。
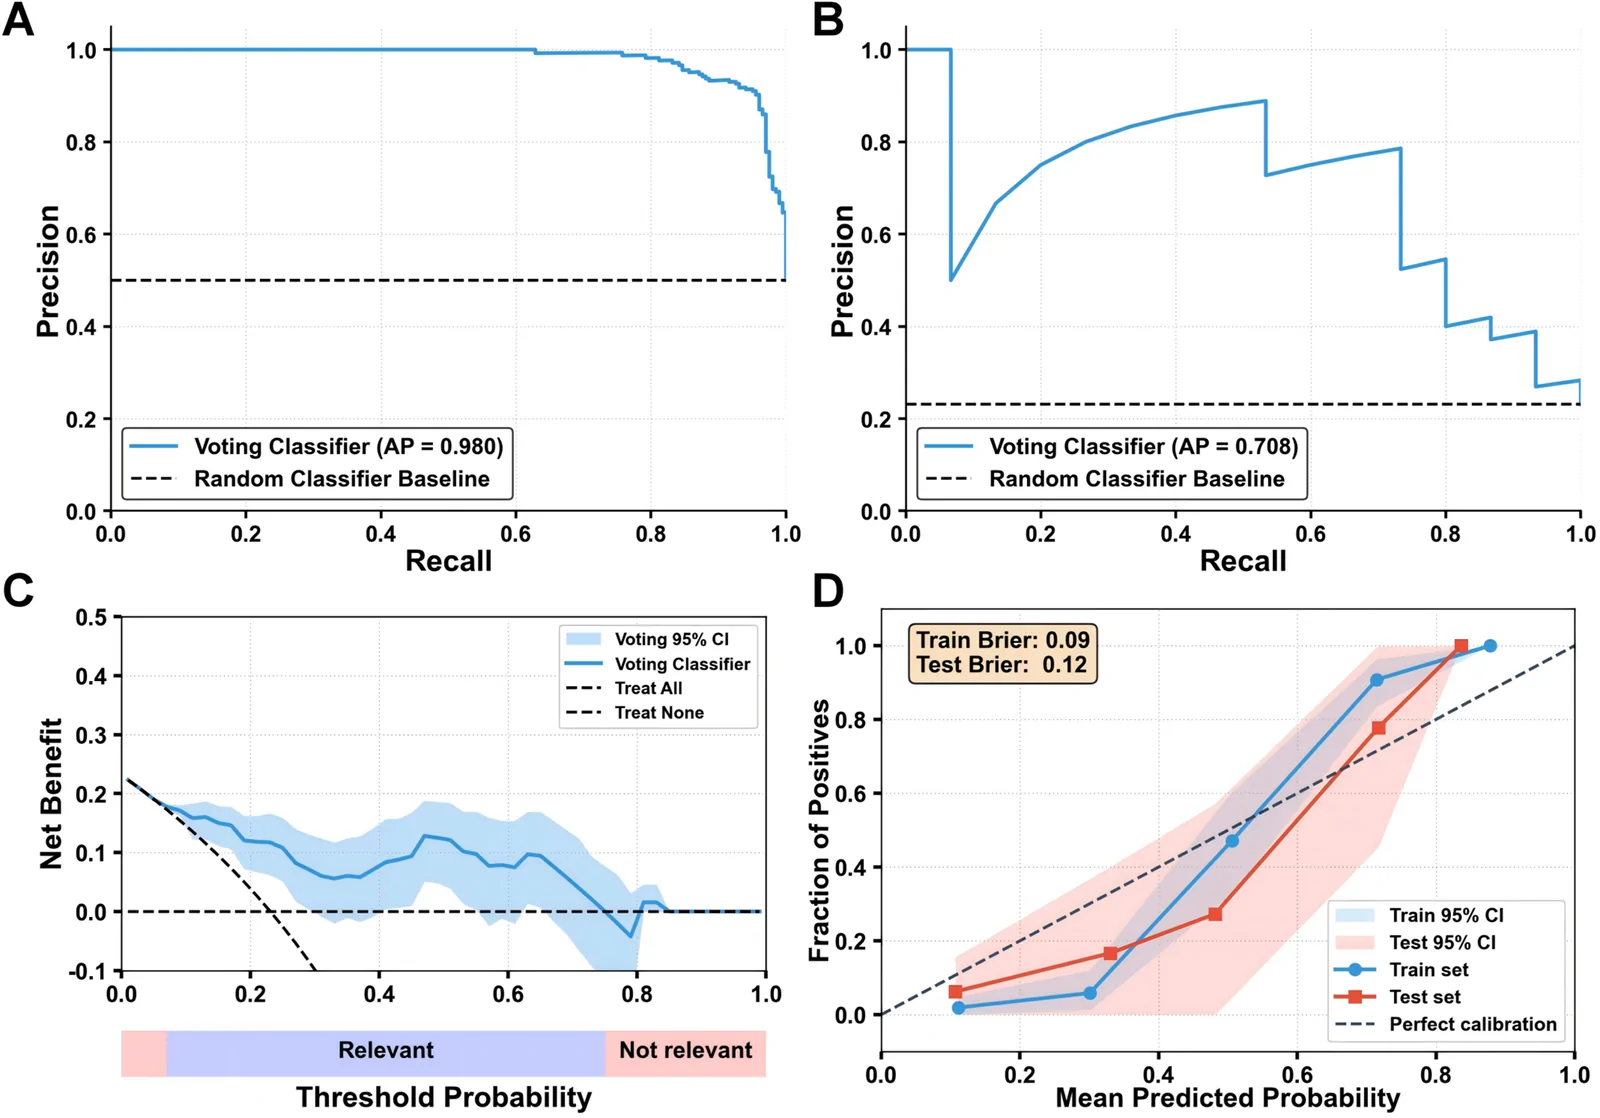
结果显示,该集成模型在测试集上取得AUC为0.861(95% CI: 0.727–0.963),准确率为0.892(95% CI: 0.815–0.954),特异度为0.940(95% CI: 0.860–1.000);5折交叉验证的平均AUC为0.915±0.064;独立外部验证(福建医科大学附属第一医院新收集队列)的AUC为0.798(95% CI: 0.668–0.900)。决策曲线分析(DCA)显示,在阈值概率0.07至0.75范围内,模型具有更高的净获益;校准曲线良好(Brier评分=0.12)。这说明模型不仅区分能力好,而且预测概率与实际观察结果一致性高。
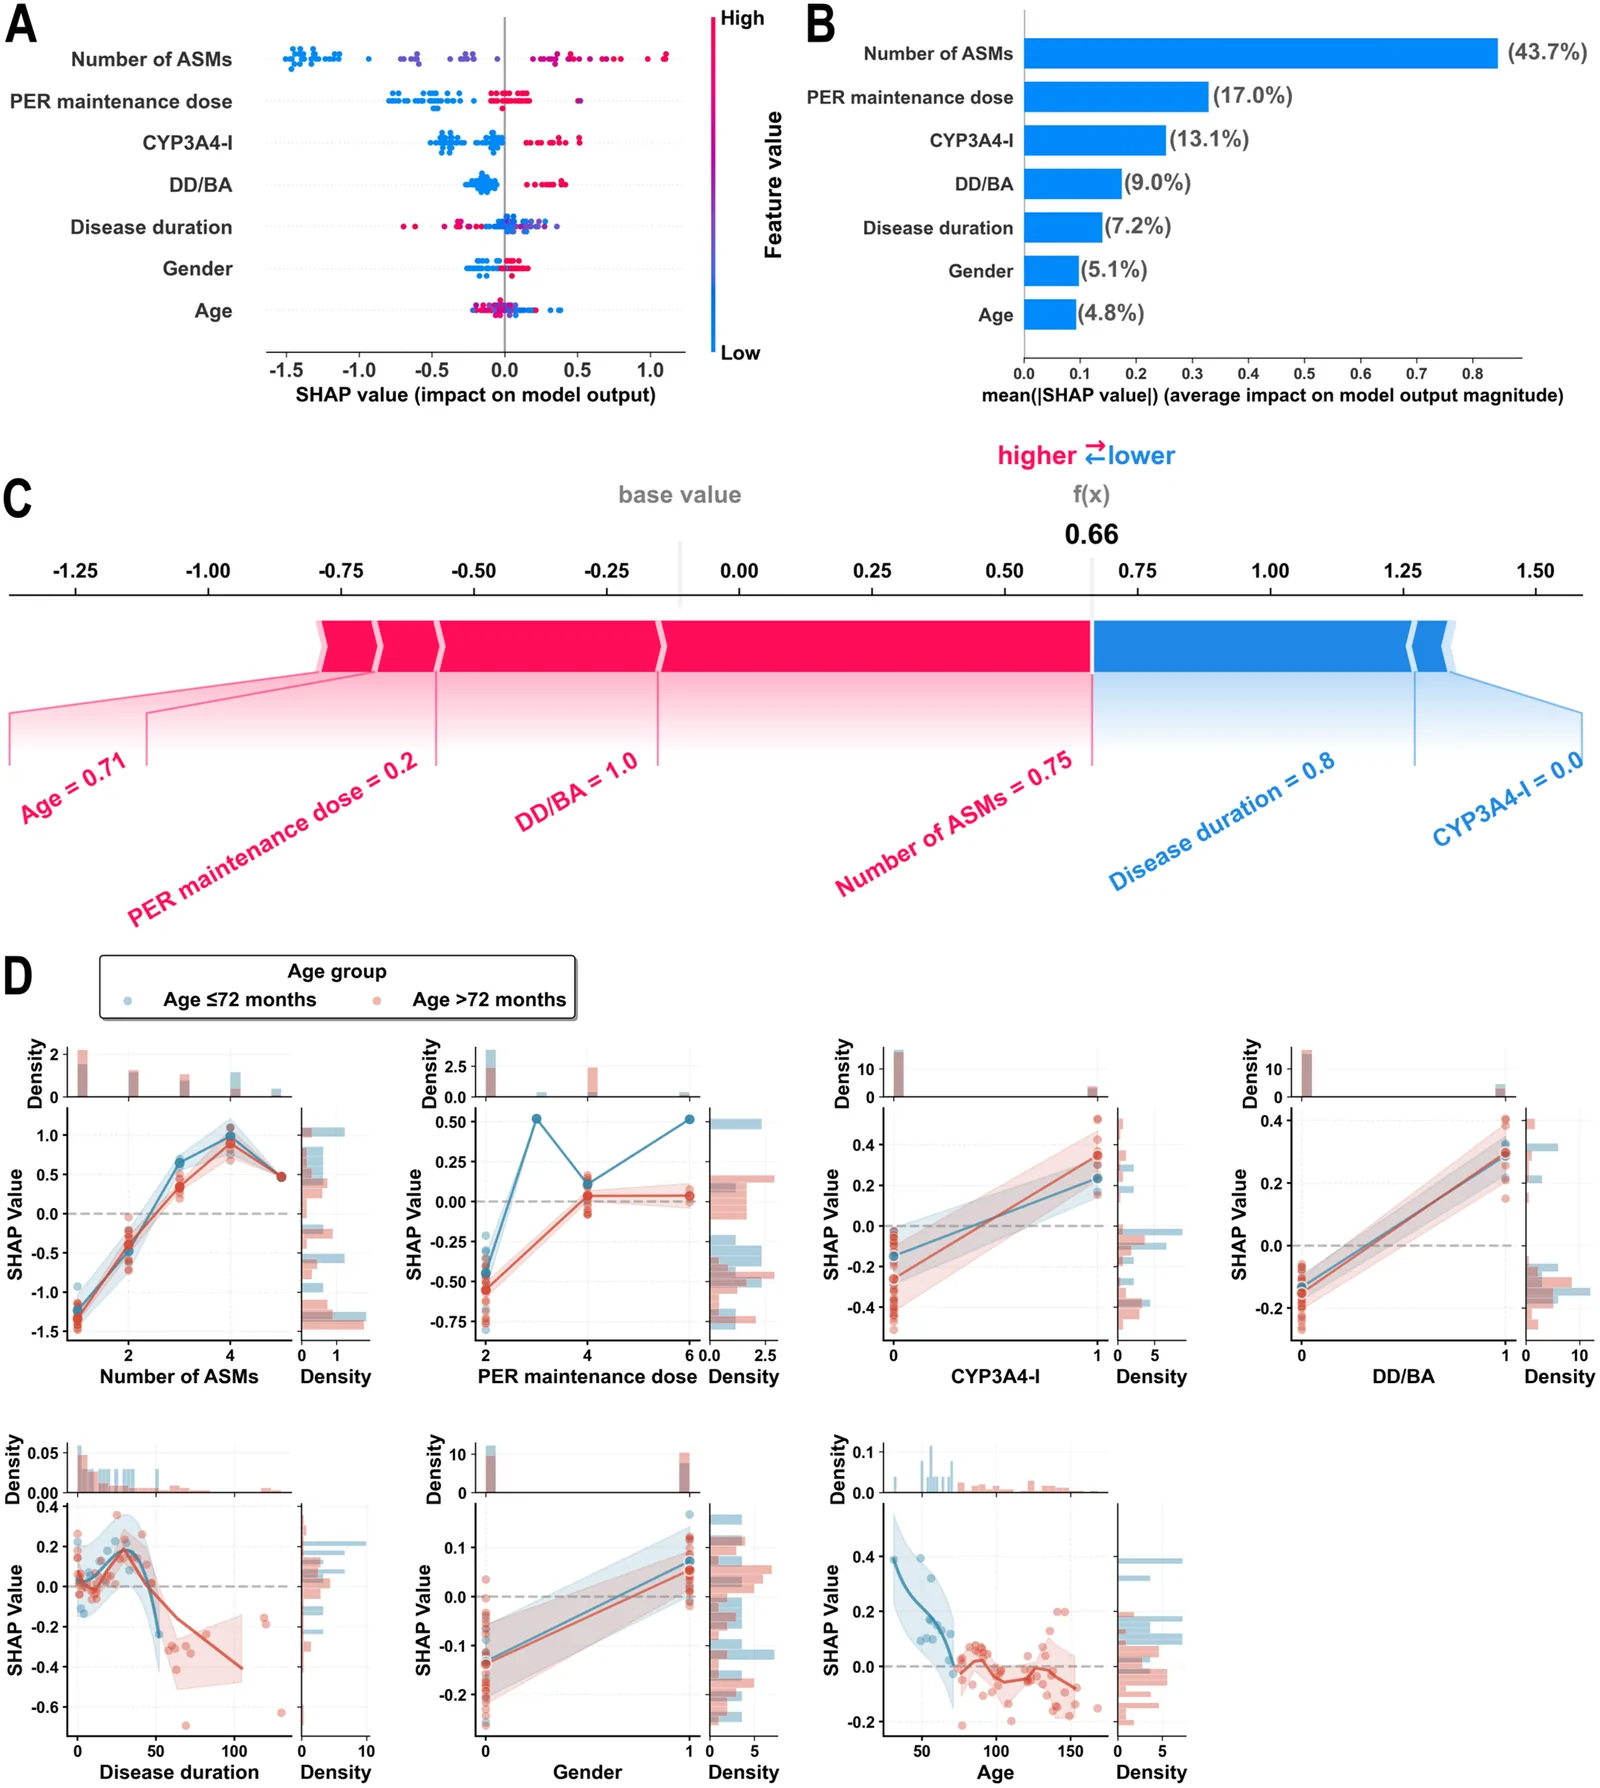
借助SHAP(SHapley Additive exPlanations)可解释性分析,研究识别出三个最主要的预测因子:合并ASM数量(贡献43.7%)、PER维持剂量(17.0%)、以及CYP3A4酶诱导剂使用(13.1%),且三者均与治疗无应答呈正相关。也就是说,合用抗癫痫药种类越多、PER维持剂量越高、同时使用了卡马西平、奥卡西平、苯巴比妥或苯妥英等CYP3A4诱导剂,患儿在2个月时更可能达不到≥50%的发作减少。
探索性年龄分层SHAP分析(≤72个月 vs >72个月)提示:多药联合、较高PER维持剂量以及较短病程与预测无应答之间的关联,在更低龄儿童中可能更为明显。这为儿科精准用药提供了年龄维度的线索。
方法亮点:从数据到可解释模型的完整流程
研究首先进行了严格的数据预处理:定性变量数值化、格式标准化,剔除缺失率超过15%的行或列;连续变量用中位数填补、分类变量用众数填补,且填补参数仅来自训练集并应用于测试集与外部队列;采用MinMaxScaler归一化,缩放参数也仅从训练集估计,以防止数据泄露。
针对类别不平衡问题,研究先按目标变量分层抽样,以8:2比例将队列分为训练集(260例)和测试集(65例),保证两类比例一致;随后仅在训练集上应用SMOTE合成少数类样本(训练集扩至404例),测试集与外部验证队列均不接触任何合成样本,也不进行过采样。
由于线性关联分析显示各协变量与结局之间线性关系很弱(|r|≤0.36),研究转而采用多种非线性机器学习分类器建模。特征筛选流程如图1所示:从数据收集、处理与协变量选择、处理数据不平衡,到模型构建、评估与解释,形成闭环。
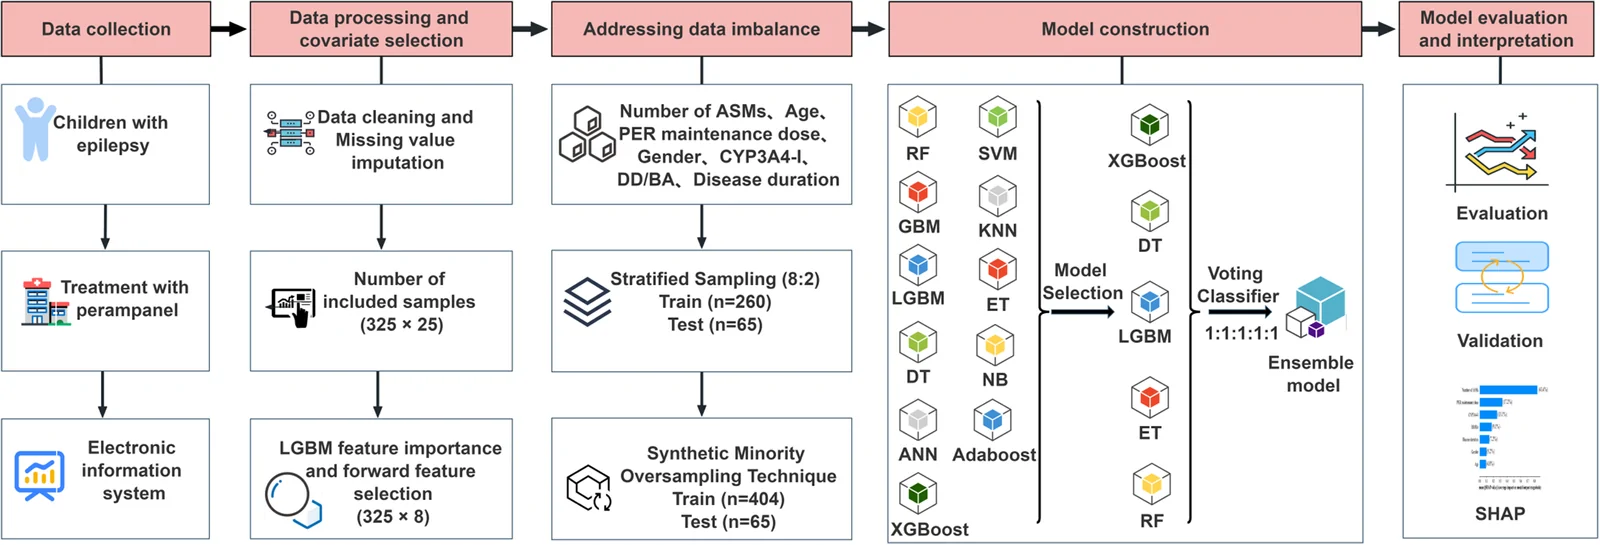
在协变量筛选环节,先用完整训练集拟合LightGBM(max_depth=5)得到特征重要性排序,再按该顺序逐个加入特征,构建1至24个嵌套子集,每个子集通过5折交叉验证评估平均ROC AUC,选择最优子集;并计算所选特征间Spearman相关,剔除|r|>0.7的强相关中较不重要的变量,迭代至无强线性相关为止。图2直观展示了这一最优特征子集的确定过程。
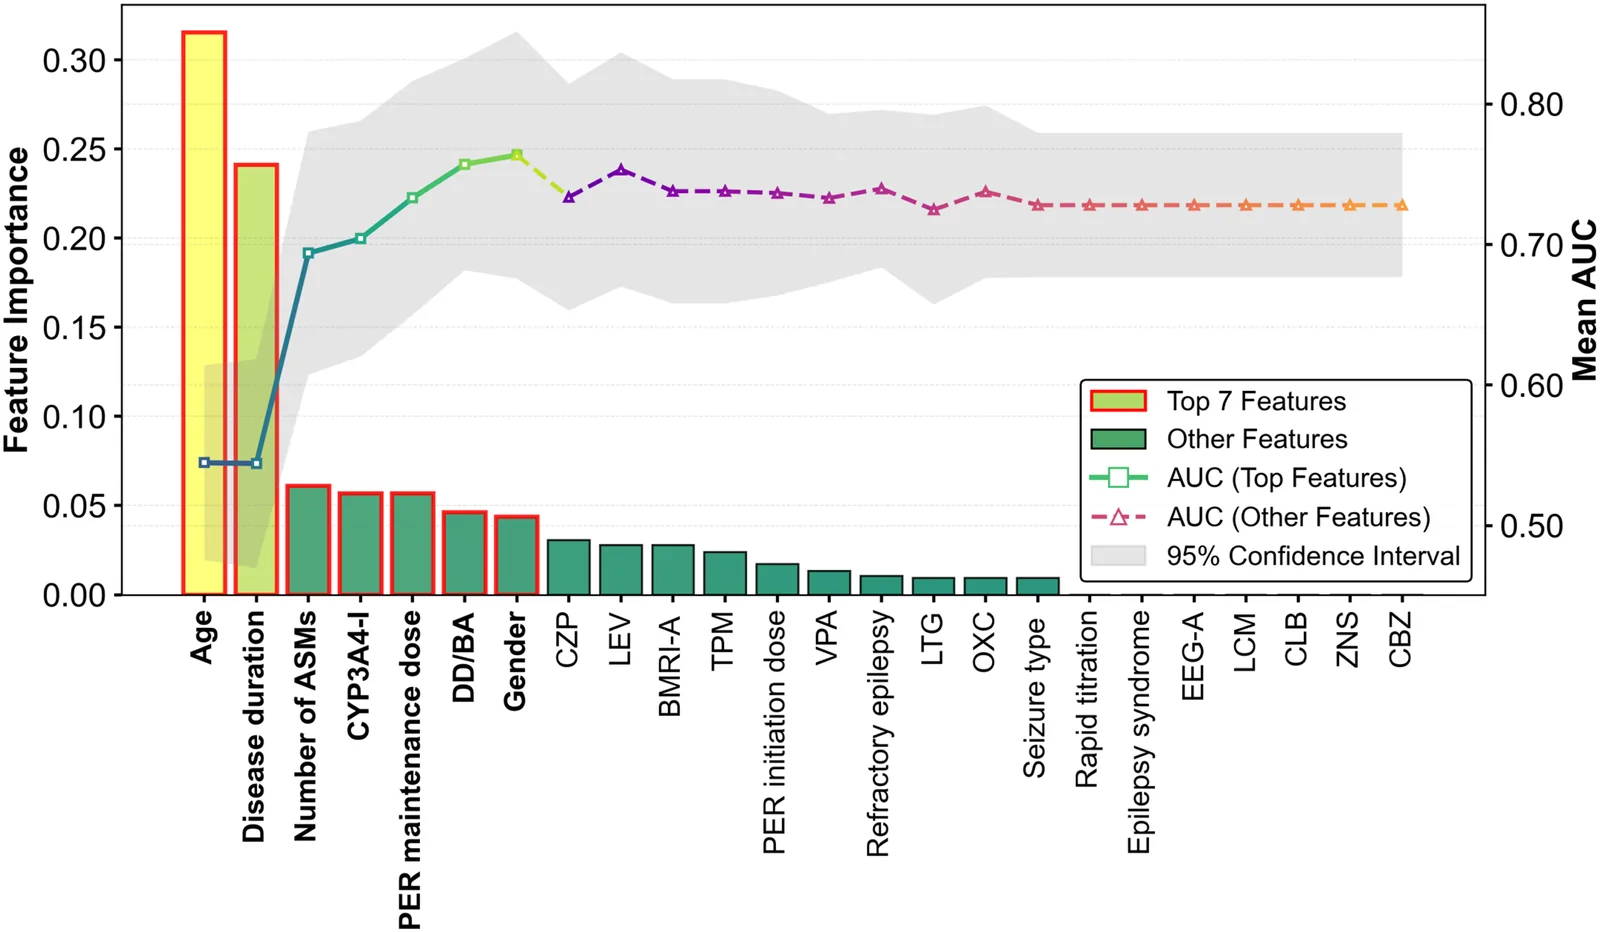
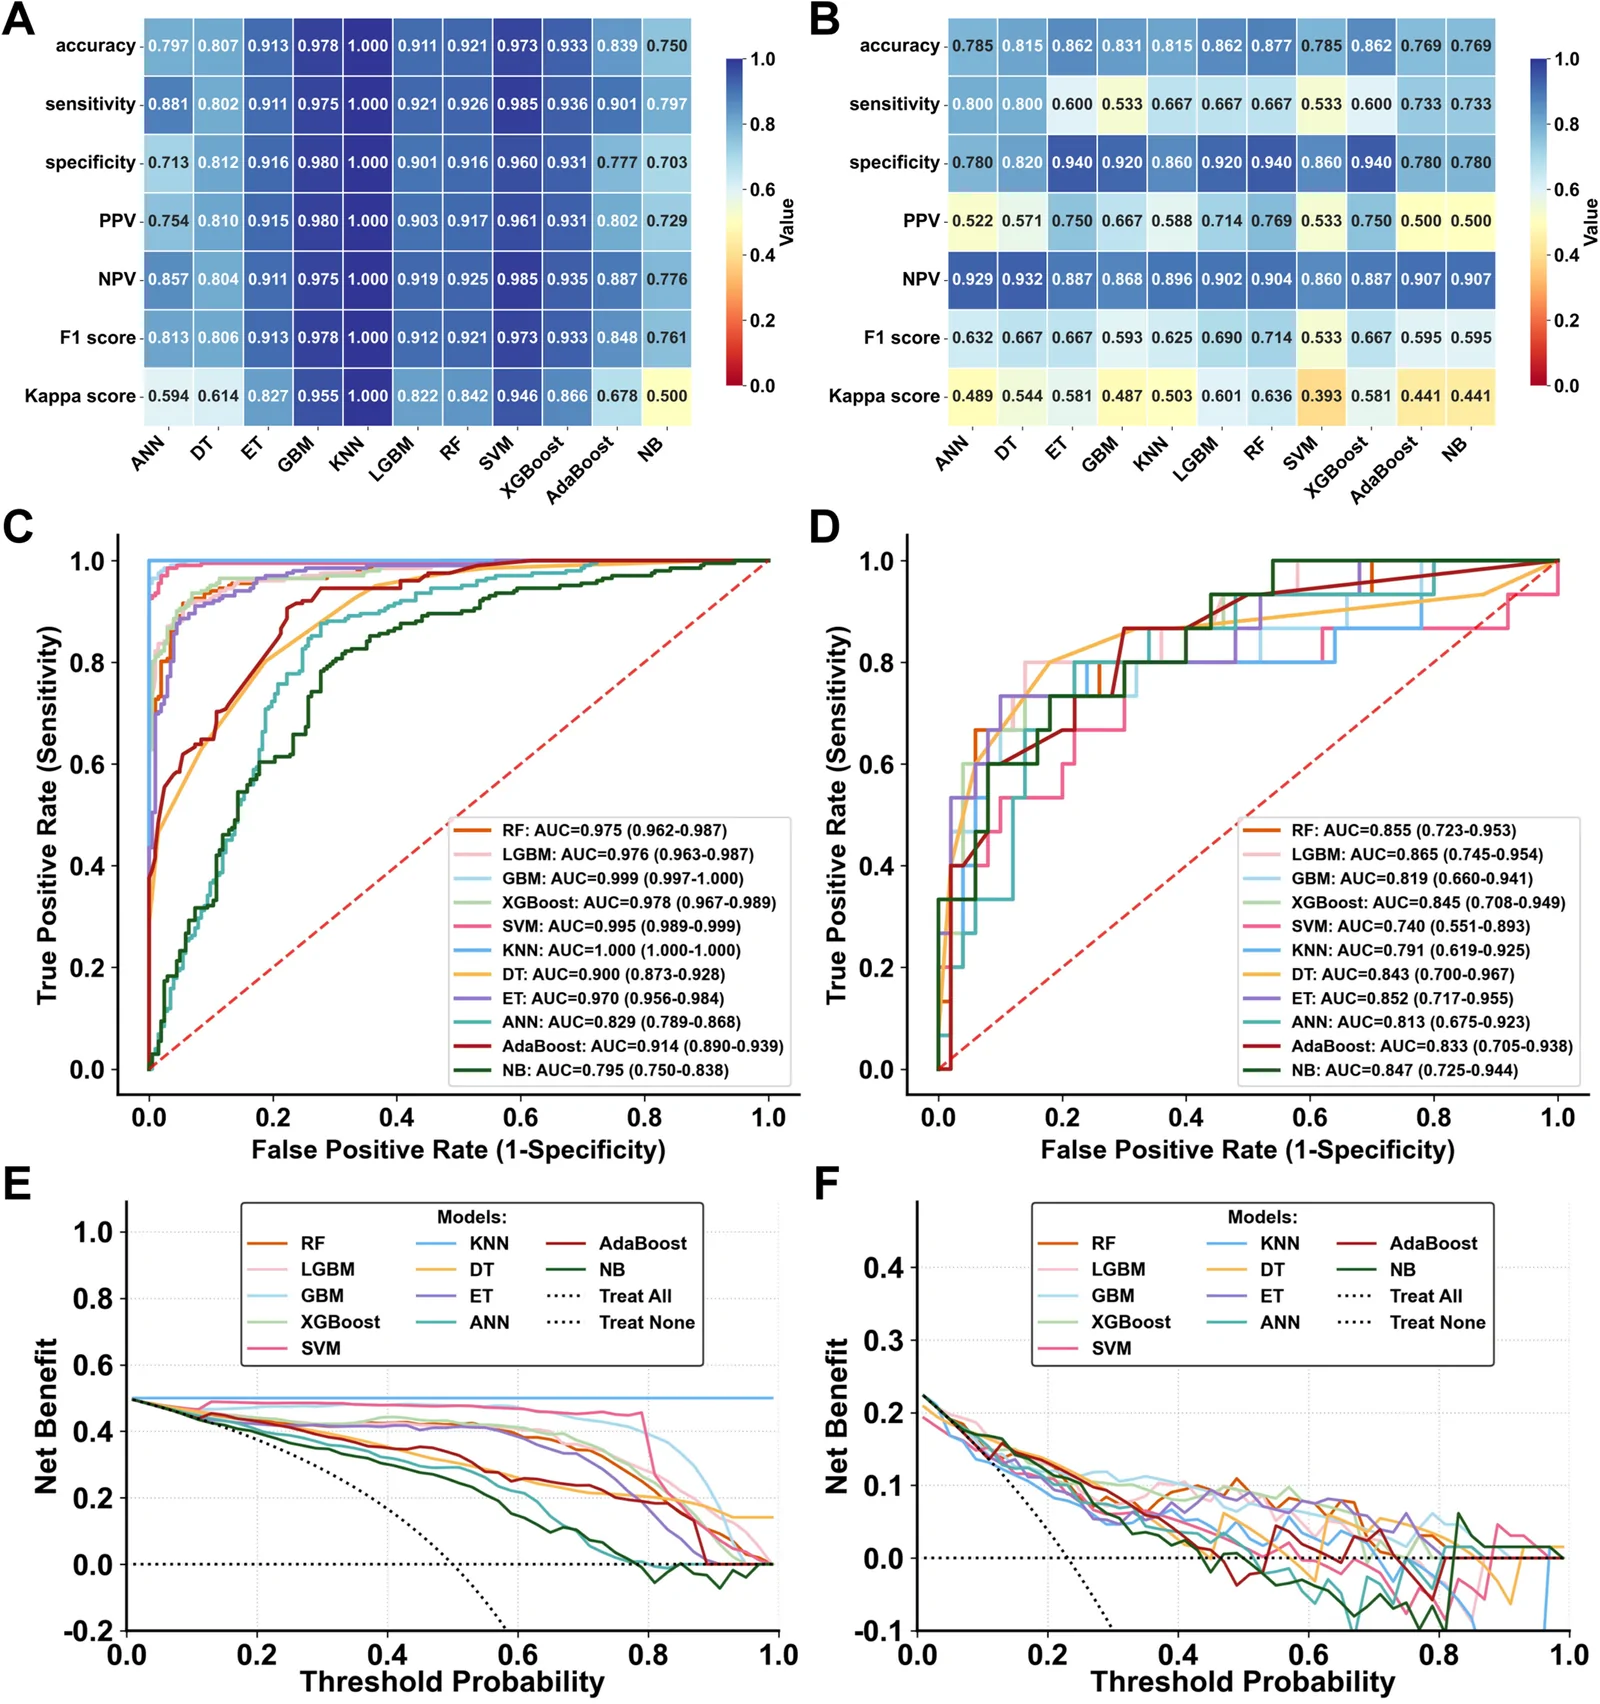
图3比较了11种机器学习算法在训练集和测试集上预测PER治疗反应的性能热图,为后续挑选基模型提供依据。
在选出表现稳定的基模型后,研究通过软投票集成策略构建融合模型,并在图4中比较了集成模型与基模型在训练集和测试集上的预测性能。
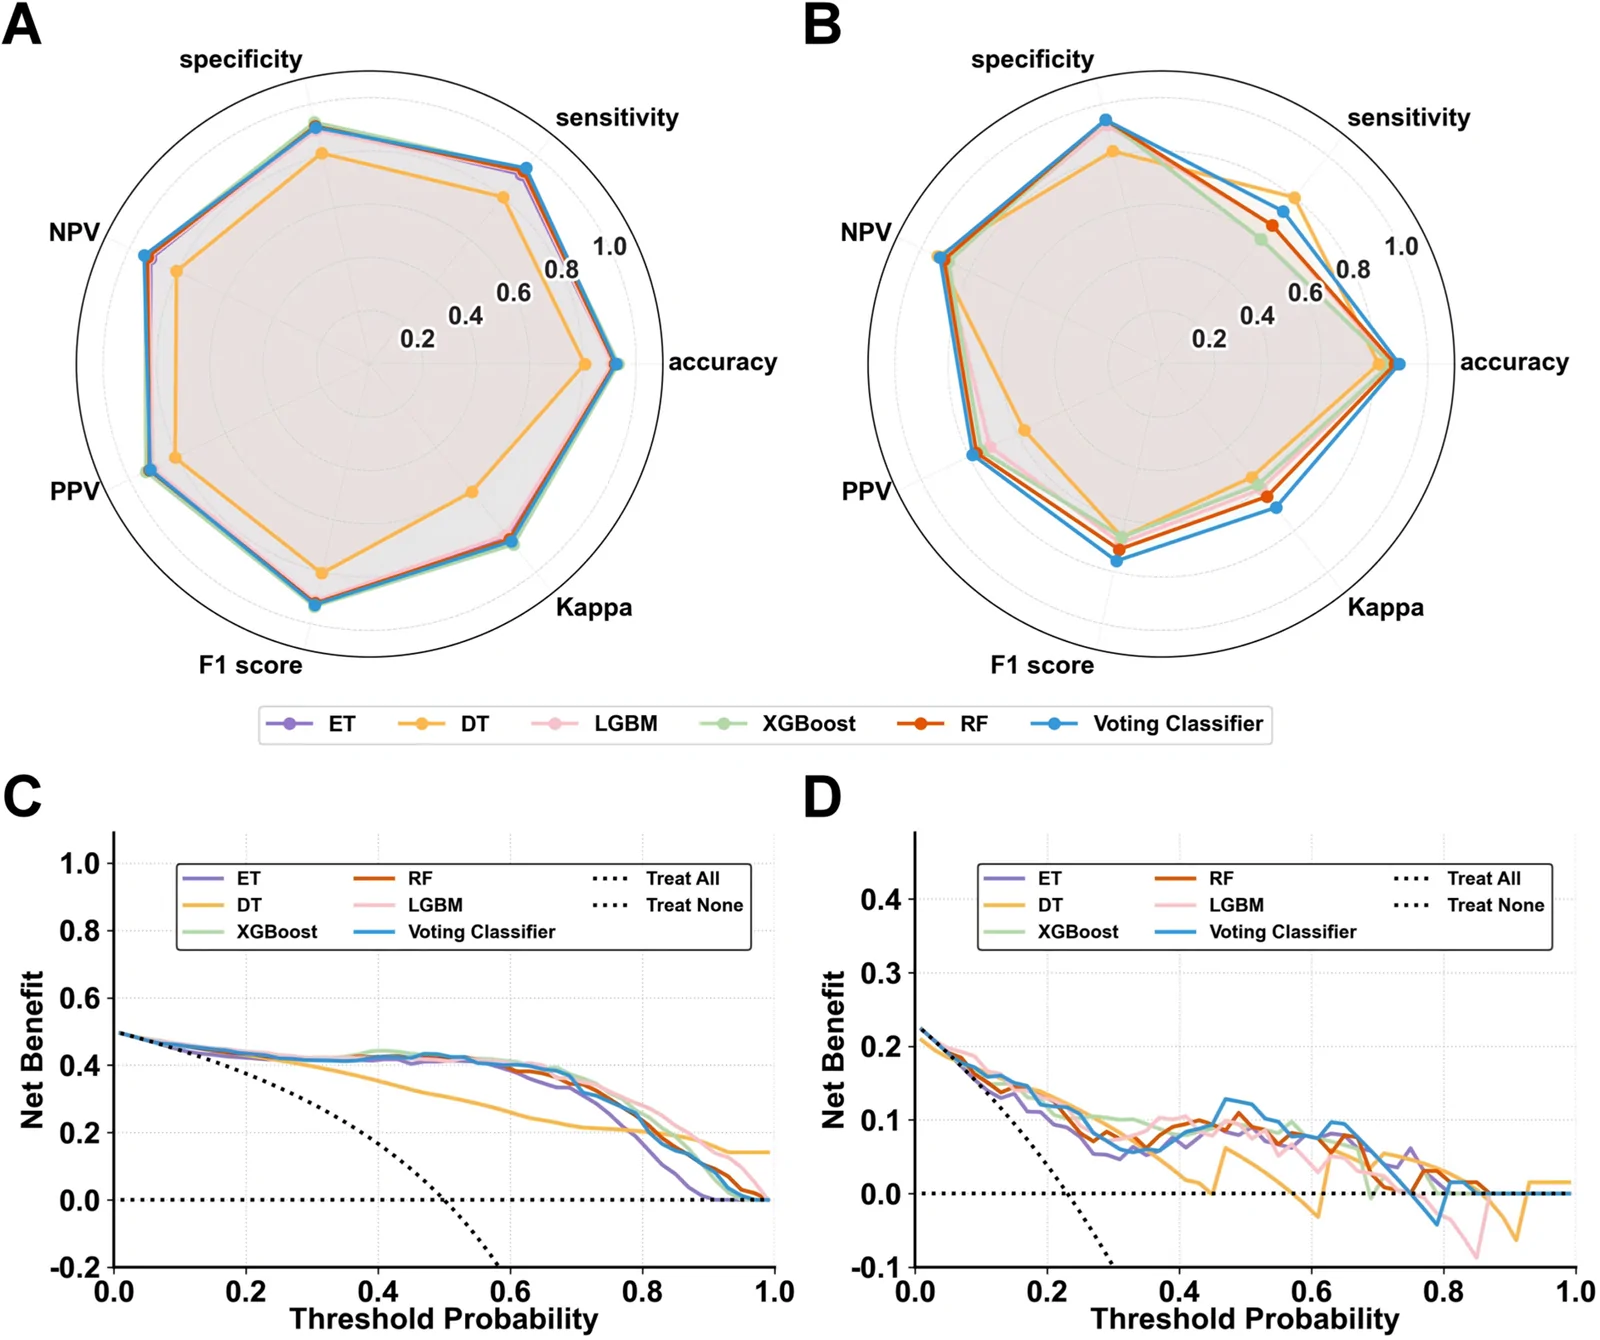
图5进一步对集成模型进行了可视化评估:包括训练集和测试集的精确率-召回率(PR)曲线,以及决策曲线分析(DCA)结果,证明其在不平衡数据下仍具 positive predictive 价值与临床净获益。
最后,图6通过SHAP蜂群图等形式解释集成模型:每个点代表一个样本某特征取值对应的SHAP值,特征按全局重要性自上而下排序,从而把“黑箱”模型转化为临床医生可理解的决策依据。
应用意义:无需血药浓度的早期预警工具
这项研究的临床价值在于,它提供了一个不依赖血药浓度检测、仅基于常规临床协变量即可运行的早期疗效预测工具。在真实世界儿科门诊或住院场景中,医生在PER启动前后即可获得年龄、性别、病程、发作类型、合并ASM数量、是否合用CYP3A4诱导剂、发育/行为情况以及计划维持剂量等信息,输入模型便能估计患儿在8周时应答的可能性。
与既往基于logistic回归的列线图相比,本研究的集成学习模型能自动捕捉多维临床变量间的非线性关系和交互作用,而无需预先设定函数形式;同时引入SHAP进行变量贡献量化与可视化,弥补了传统模型“只给系数、难解释复杂模式”的不足。此外,研究不仅做了内部测试集和5折交叉验证,还用锁定流程(locked pipeline)在独立外部队列上验证——包括直接应用开发训练集得出的MinMaxScaler参数、填补值、最终七特征集和集成模型,外部队列不进行特征选择、调参或SMOTE,从而更真实地反映泛化能力。
需要注意的是,作者也明确该模型是“早期治疗风险分层工具”,用于治疗最初2个月内的失效预警和剂量策略参考,而不是预测长期发作完全控制或安全性的工具。未来若能在更大规模、多中心、前瞻性队列中进一步验证,并嵌入电子病历系统,这类可解释机器学习模型有望帮助儿童神经科医生在PER治疗决策中减少“试错式处方”,推动癫痫精准治疗走向常规实践。
论文发表于《Drug Design, Development and Therapy》(影响因子6.1),题为“Explainable Machine Learning for Predicting Early Response to Perampanel in Pediatric Epilepsy: A Real-World Study”,为儿童癫痫个体化用药提供了兼具准确性与可解释性的新范式。
本文图片转载自 PMC 开放获取全文,仅供学习参考,请以原文为准。